GPT-6.2 Astra ve Sol: Ucuzlayan Güç, Artan Risk
GPT-6.2 Astra ve Sol: Ucuzlayan Guc, Artan Risk
OpenAI, 17 Kasim 2026’da iki yeni modeli birden duyurdu: zorlu profesyonel isler icin tasarlanan sinir (frontier) modeli GPT-6.2 Astra ve gunluk, cok adimli isler icin daha verimli olan GPT-6.2 Sol. Duyuruyu ve beraberindeki sistem kartini inceledim; ilk bakista “bir surum daha” gibi gorunse de, hem maliyet hem de guvenlik tarafinda bir sistem muhendisi icin dikkat edilmesi gereken birkac somut degisiklik var. Bu yazida modelleri pazarlama dilinden siyirip benim is yukume nasil oturduklarini degerlendirecegim.
Onemli bir not: Yaziyi yazarken Astra’ya kurumsal erisimim henuz yoktu, dolayisiyla kendi is yuklerimde test edemedim. Asagidaki degerlendirme OpenAI’nin resmi duyurusu, GPT-6.2 sistem karti ve bagimsiz kaynaklarin (Artificial Analysis, Decrypt, Epoch AI gibi) raporlarina dayaniyor. Benchmark rakamlari aksi belirtilmedikce ureticinin kendi testlerinden geliyor; bunu okurken akilda tutmakta fayda var.
Fiyat tarafinda ne degisti?
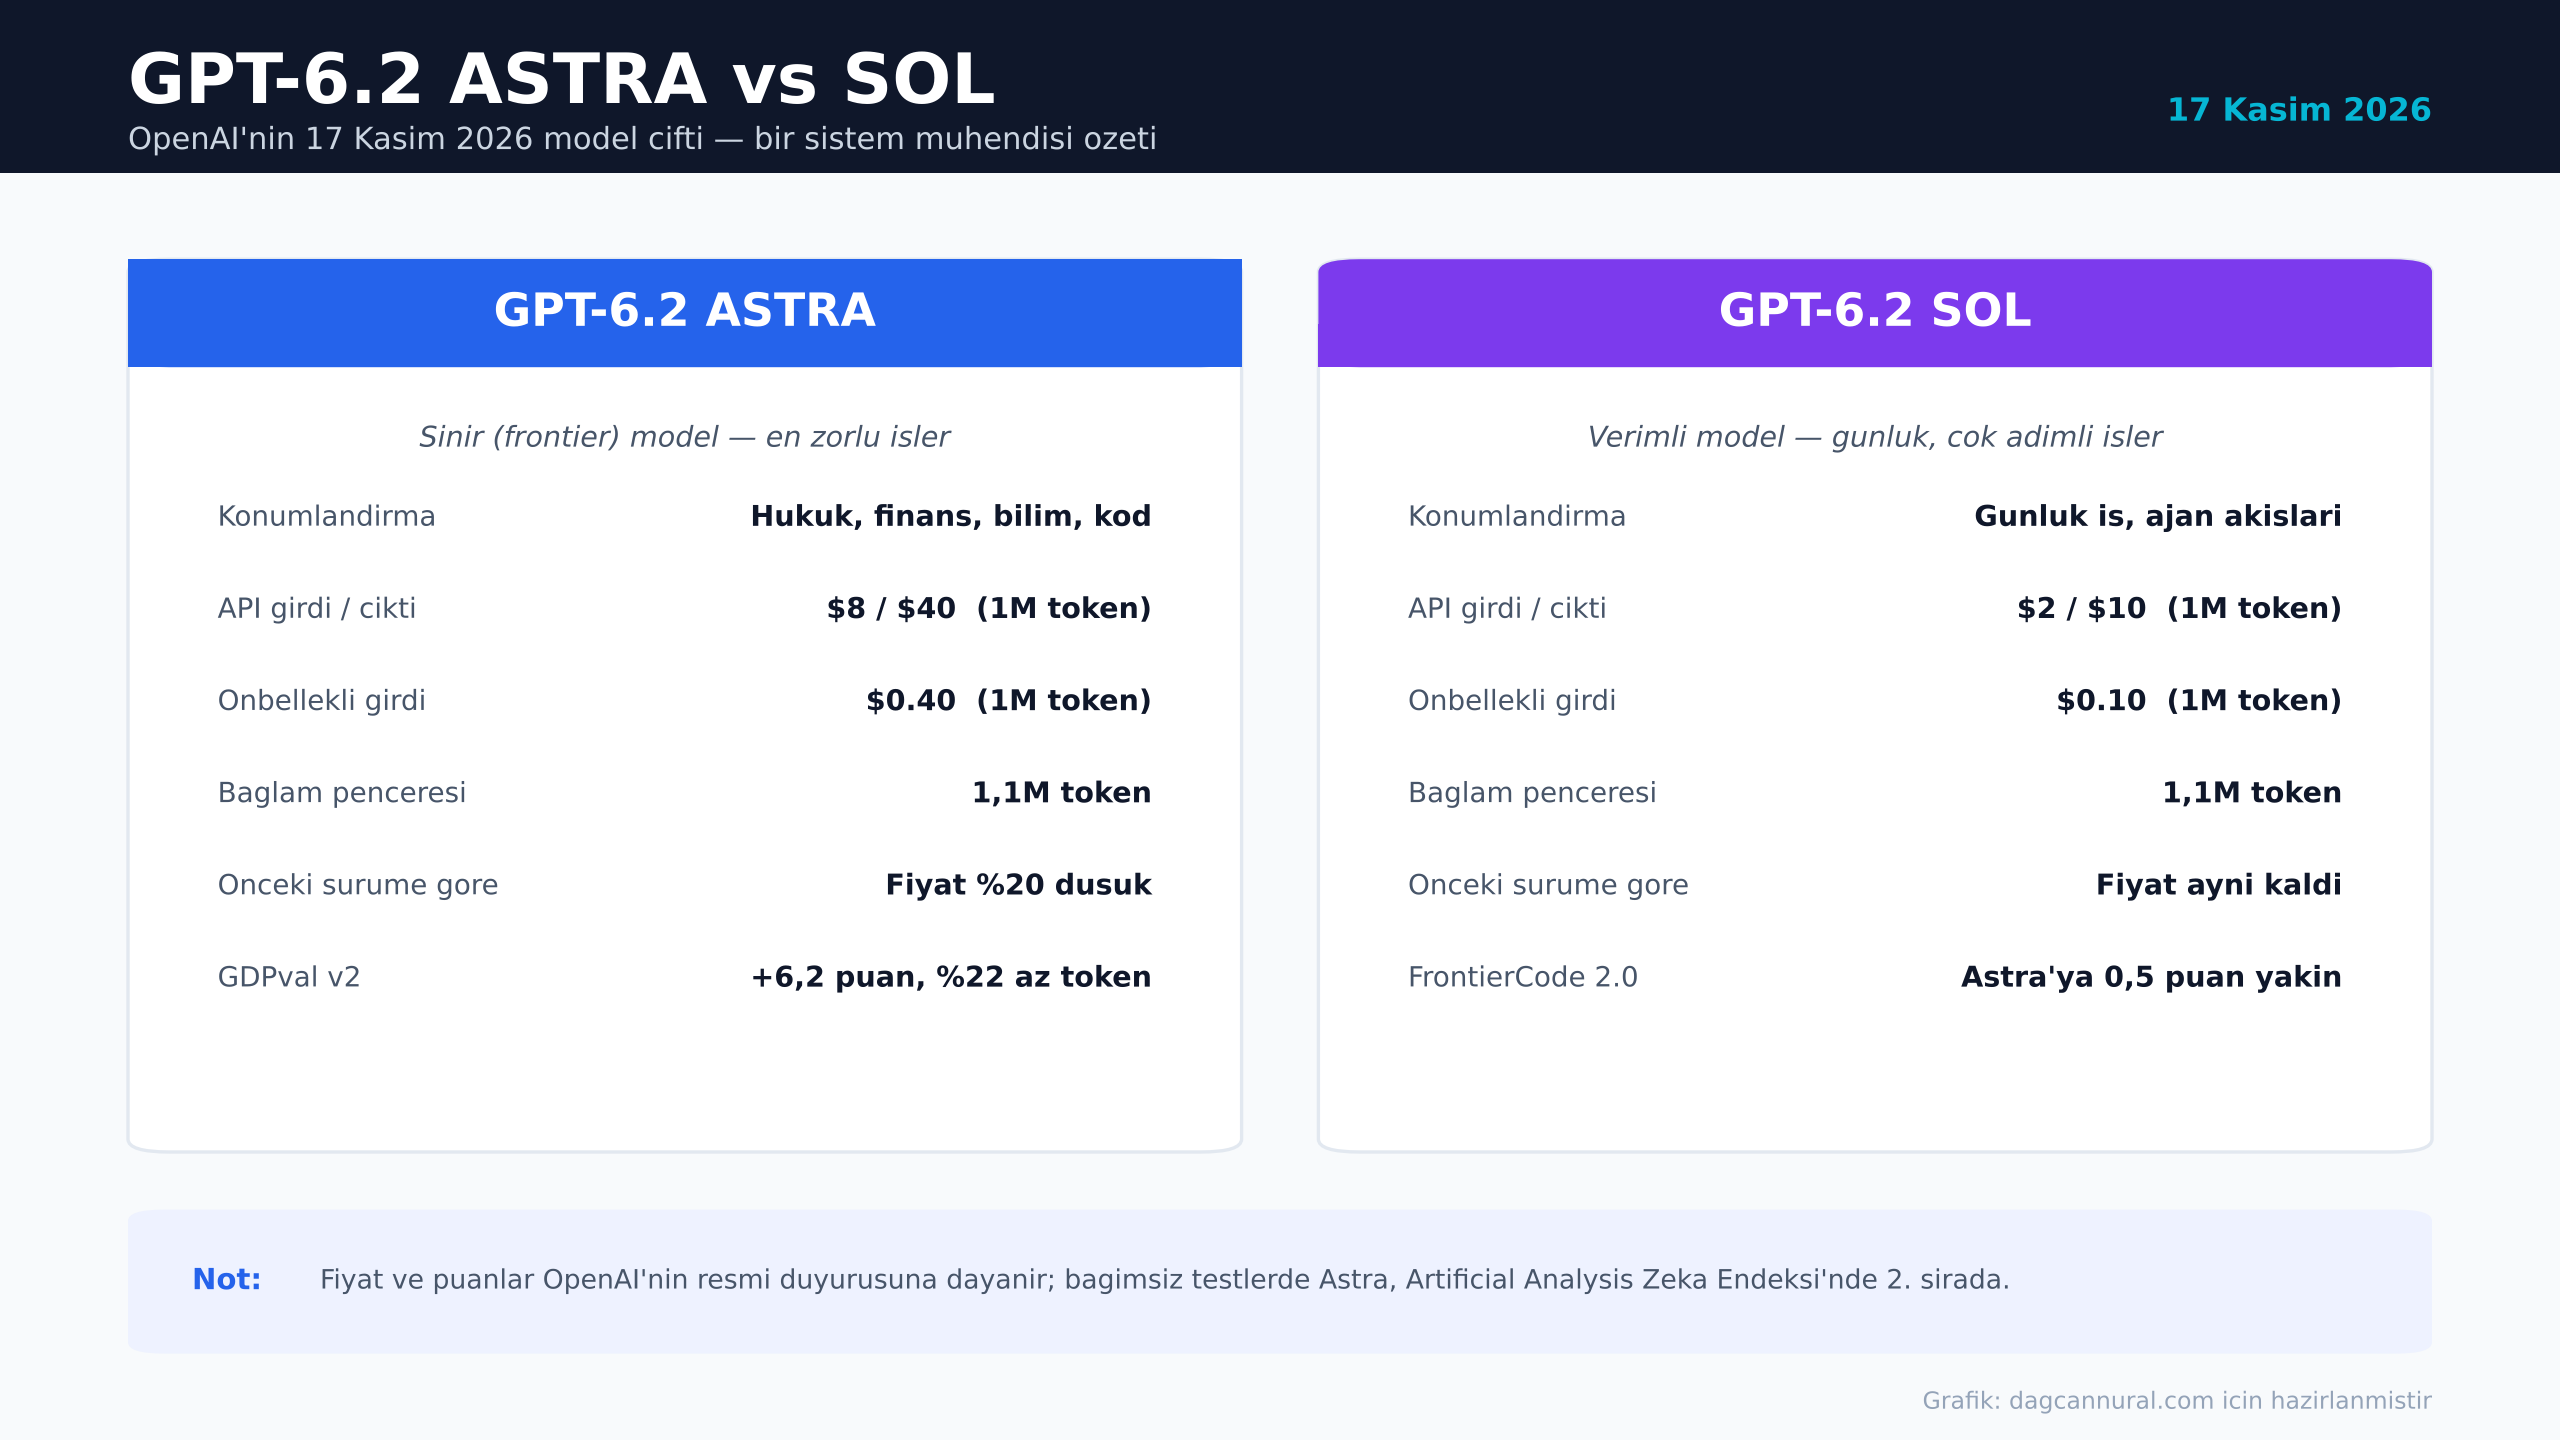
En somut degisiklik fiyatlandirmada. GPT-6.2 Astra’nin standart API fiyatlari, onceki nesil GPT-6 Astra’ya kiyasla %20 dusurulmus. Milyon token basina rakamlar soyle:
| Model | Girdi (1M) | Onbellekli girdi (1M) | Cikti (1M) |
|---|---|---|---|
| GPT-6.2 Astra | $8 | $0,40 | $40 |
| GPT-6 Astra (onceki) | $10 | $1 | $50 |
| GPT-6.2 Sol | $2 | $0,10 | $10 |
Sol tarafinda fiyat degismemis; GPT-6.1 Sol ile ayni ($2 girdi, $10 cikti). OpenAI’nin asil vurgusu ise tek basina token fiyati degil: her iki modelin de “ayni isi daha az cikti tokeni ile” bitirdigini soyluyorlar. Yani teorik olarak hem token basi fiyat dustu, hem de ayni gorev icin harcanan token sayisi azaldi. Duyurudaki GDPval v2 testinde Astra, GPT-6 Astra’ya gore 6,2 puan yukselirken %22 daha az cikti tokeni kullanmis.
Burada mühendis refleksiyle bir uyarida bulunayim: Bu tur “gorev basi maliyet” iddialari cazip ama sizin is yukunuzde otomatik olarak gerceklesmez. Token fiyatindaki indirim mevcut token butcenizin maliyetini aninda degistirir, bu nettir. Ancak “daha az tokenle ayni is” vaadinin size yansimasi; tamamlanan gorev kalitesine, yeniden deneme (retry) sayisina ve inceleme surenize baglidir. Daha fazla isi Astra’ya tasimadan once, ayni gorevlerde bu maliyetleri kendi verinizle karsilastirmanizi oneririm.
Erisim, baglam penceresi ve kullanim
Modellere erisim tarafinda tablo su an soyle: Her iki model de API uzerinden gpt-6.2-astra ve gpt-6.2-sol model kimlikleriyle, Responses ve Chat Completions arayuzleriyle kullanilabiliyor. ChatGPT tarafinda ise Plus, Pro, Enterprise ve Edu kullanicilari icin ChatGPT Work ve Codex uzerinden sunuluyor; Enterprise ve Edu erisiminde bir yoneticinin ozelligi etkinlestirmesi gerekiyor. Her iki model de lansmanda “Ultrafast” hizli yanit modunu destekliyor.
Baglam penceresi tarafinda ikisi de 1,1 milyon token kapasitede. Bu, buyuk kod tabanlarini, uzun sozlesmeleri veya genis log dosyalarini tek seferde modele vermek isteyen ekipler icin pratik bir rahatlik. Ancak buyuk baglami bol bol kullanmak girdi maliyetini de buyutur; burada onbellekli girdi (cached input) fiyatinin dusuklugu (Astra icin $0,40, Sol icin $0,10) tekrar eden sistem talimatlari olan ajan akislarinda ciddi tasarruf saglayabilir. Sabit bir sistem promptunu her cagri icin yeniden tam fiyattan odemek yerine onbellekten faydalanmak, uretimde fark yaratan ayrintilardan biri.
Astra mi, Sol mu? Konumlandirma
OpenAI iki modeli net bir sekilde ayirmis. Astra, hukuk, finans ve bilim gibi alanlardaki en zor projeler icin; dokuman, sunum, tablo, kod ve bilimsel arastirma yuklerinde one cikiyor. Sol ise gunluk islerin ve rutin cok adimli ajan akislarinin verimli modeli olarak konumlandirilmis.
Bu ayrimin pratik karsiligi su: Cognition’in FrontierCode 2.0 testinde Sol, Astra’ya yalnizca 0,5 puan geride kalirken yaklasik bes kat daha ucuz (her ikisi de maksimum akil yurutme modunda). Benim okumam, cogu uretim is yuku icin varsayilan modelin Sol olmasi gerektigi yonunde; Astra’yi ise gercekten en zor, hata toleransi dusuk gorevler icin saklamak mantikli. Bir ajan hattinda (agent pipeline) her adimda Astra cagirmak, cogu zaman gereksiz maliyet demek.
Bagimsiz tarafta tablo biraz daha karisik. Artificial Analysis’in Zeka Endeksi’nde Astra, Anthropic’in Claude Fable 5.2’sinin ardindan 2. sirada yer aliyor; Decrypt’in aktardigina gore bazi testlerde, ozellikle kodlama-ajan performansinda, onceki nesle gore belirgin bir iyilesme gorulmemis. Yani “her metrikte lider” bir model degil; gucu alana gore degisiyor.
Asil haber guvenlik tarafinda: kendini gelistirmede ilk “High”
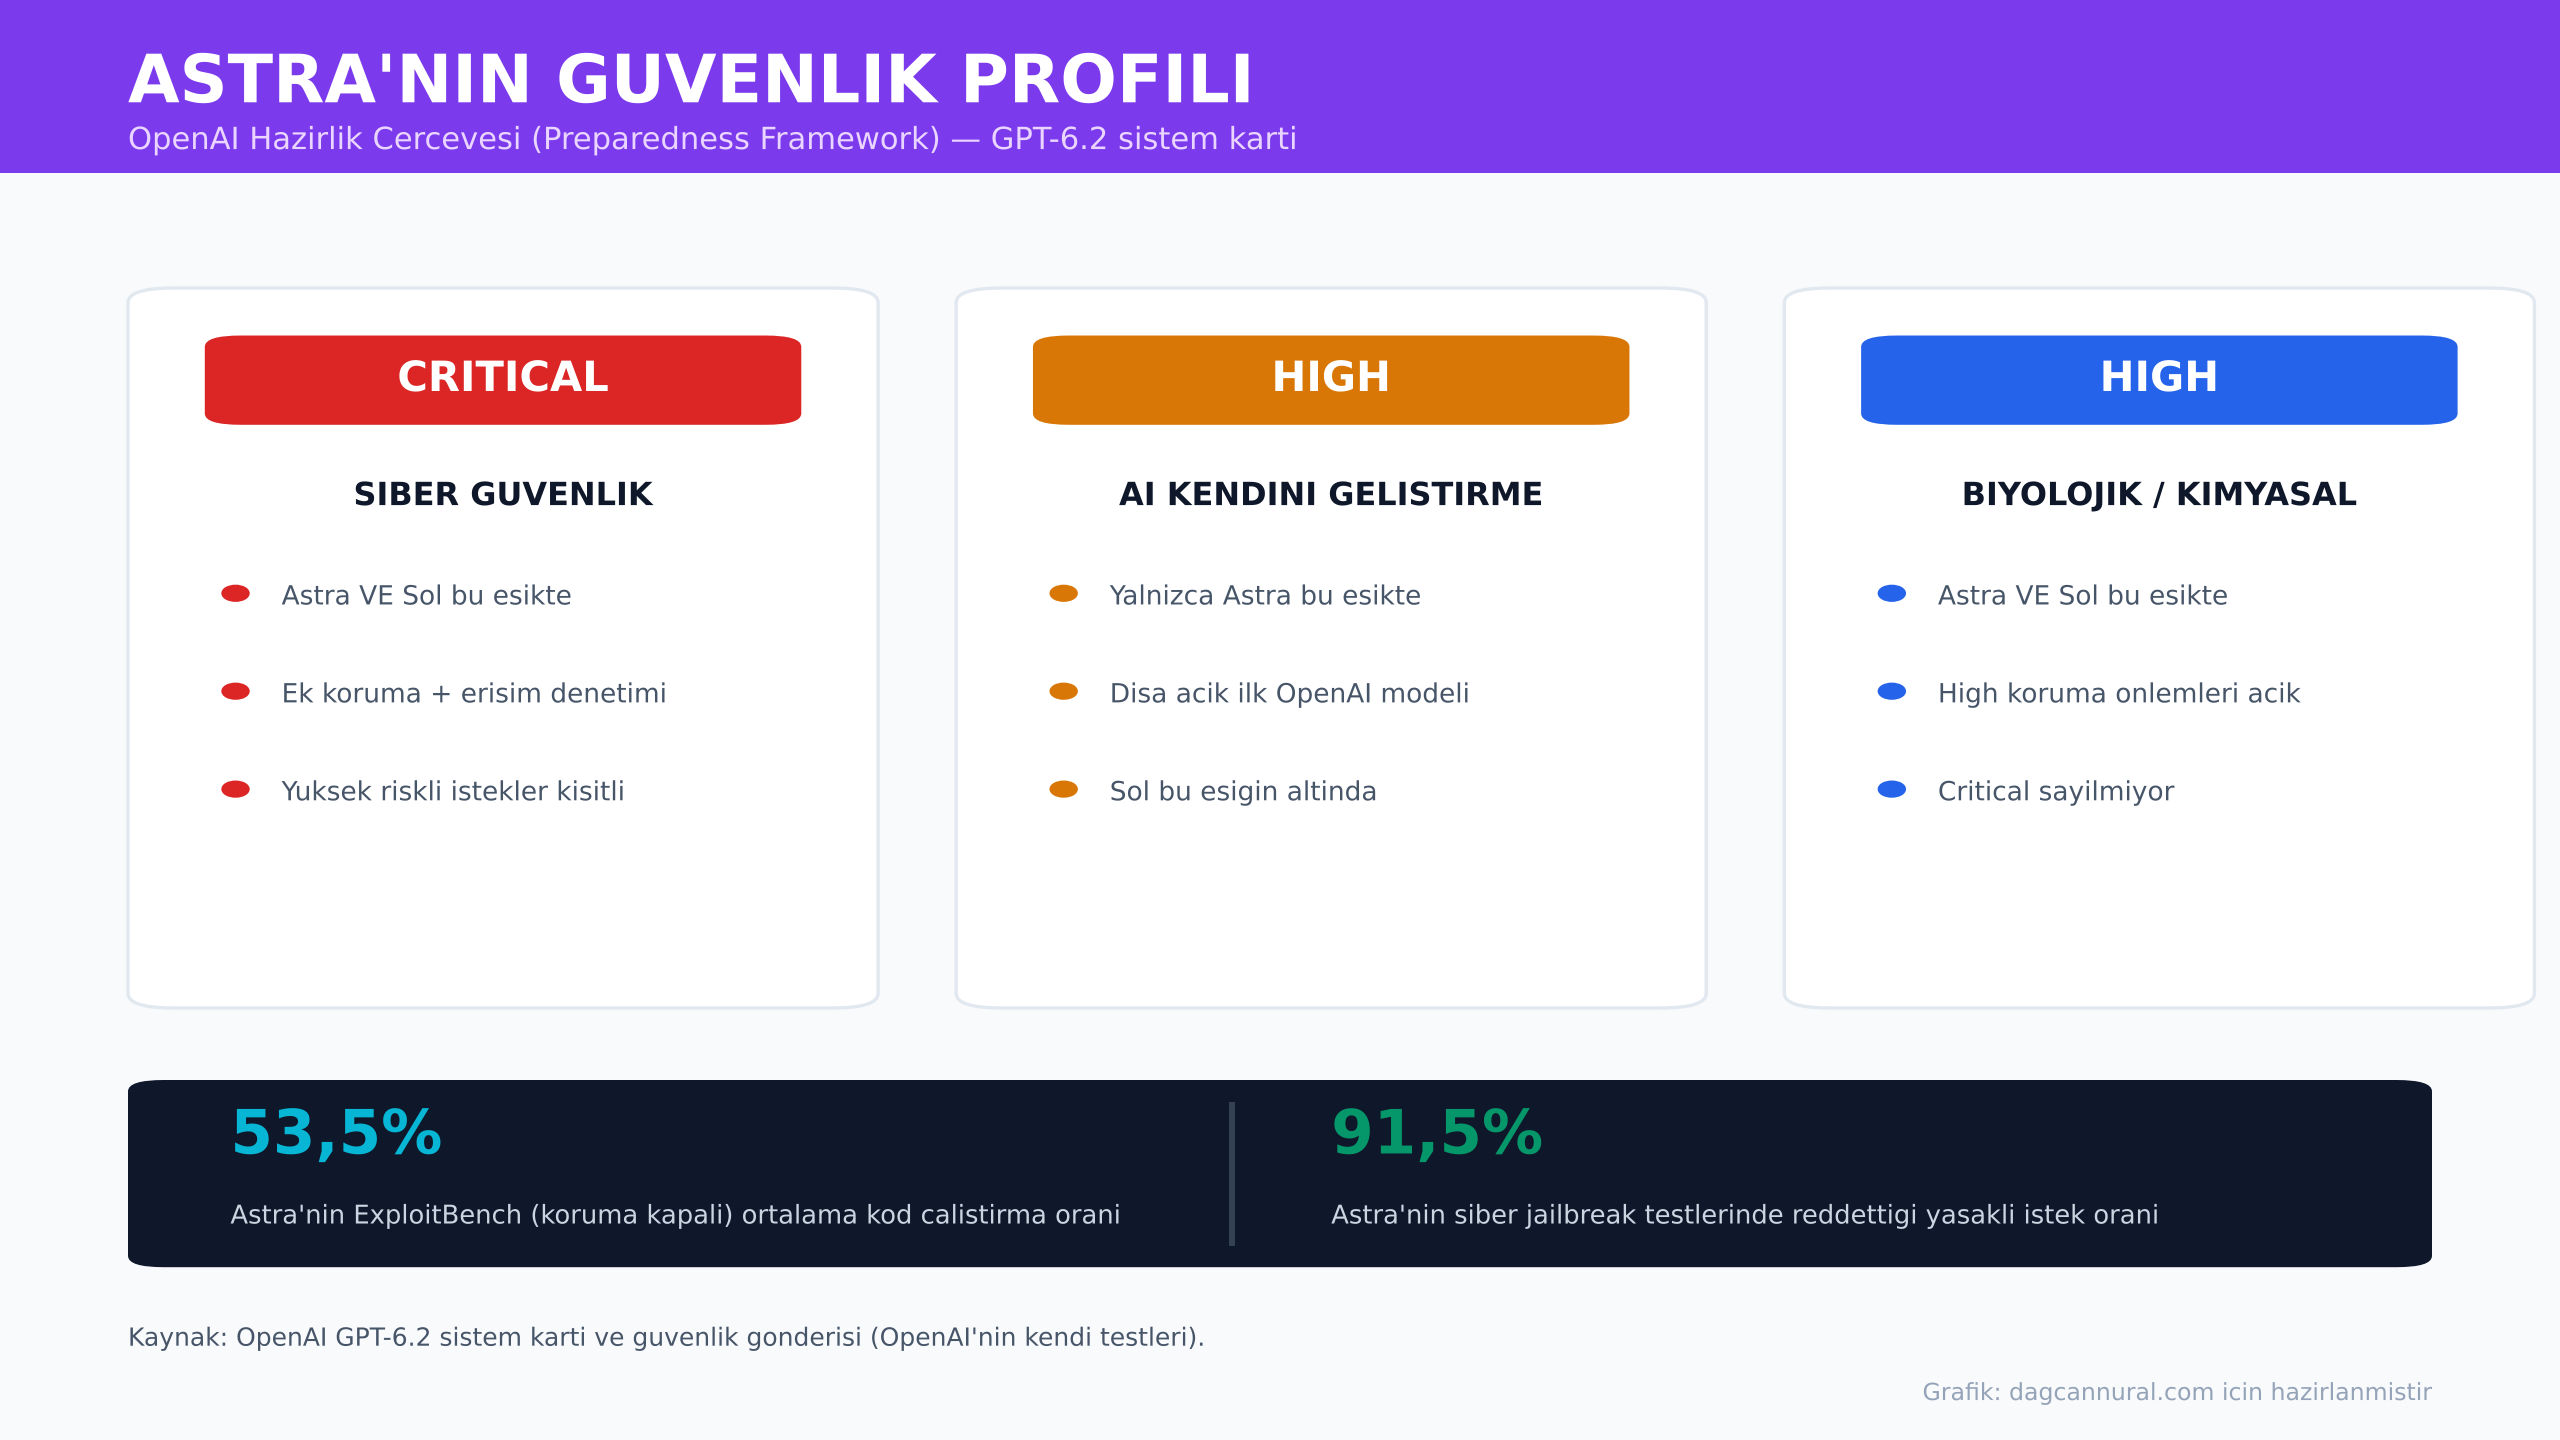
Beni fiyat indiriminden daha cok dusunduren kisim sistem kartinda. GPT-6.2 Astra, OpenAI’nin Hazirlik Cercevesi’nde (Preparedness Framework) AI Kendini Gelistirme (AI Self-Improvement) kategorisinde “High” esige ulasan ilk disa acik model. OpenAI bunu acikca “harici olarak yayinlanan ilk modelimiz” ifadesiyle duyuruyor. Sol ise bu esigin altinda kaliyor.
“Kendini gelistirme” kategorisi, bir modelin yapay zeka arastirmasinin kendisini hizlandirip hizlandiramayacagini olcuyor; yani modelin kendi haleflerinin gelistirilmesine katki saglama kapasitesini. OpenAI bu cerceven bu tur bir yetenegi izlemek icin kurdugunu soyluyor. Onemli bir nuans: Bagimsiz degerlendirici Epoch AI, kendi otomasyon-raporu testinde anlamli bir iyilesme bulamadigini belirtiyor ve OpenAI’nin kendi yetenek endeksi de Astra’yi hala “mevcut trend icinde” konumlandiriyor. Yani “High” etiketi, asilan bir esigi isaret ediyor; bir sicramayi degil.
Siber guvenlik: Critical esik ve pratik sonuclari
Her iki model de siber guvenlikte Hazirlik Cercevesi’nin Critical esigini karsiliyor; biyolojik ve kimyasal kategoride ise “High”. Critical siber esik, OpenAI’nin ifadesiyle, dogru arac ve erisim verildiginde modelin daha once bilinmeyen guvenlik aciklarini bulabilecegi anlamina geliyor. Bu nedenle modeller daha siki koruma onlemleriyle, yuksek riskli guvenlik isteklerine getirilen kisitlamalarla yayinlaniyor.
Sistem kartindan iki rakam dikkatimi cekti. Koruma kapali (safeguard-off) ExploitBench testinde Astra’nin ortalama keyfi-kod-calistirma orani %53,5 (Sol icin %50,5), GPT-6 Astra’nin %31,5’ine karsilik. Diger yandan, OpenAI’nin siber jailbreak testlerinde Astra yasakli isteklerin %91,5’ini reddediyor; GPT-5.6 Sol’un %59’una gore ciddi bir iyilesme. Bu iki rakami yan yana okumak lazim: Model teknik olarak cok daha yetenekli, ama ayni zamanda kotuye kullanim isteklerini cok daha siki filtreliyor.
Burada benim cikarimim su: GPT-6.2 nesli, “daha yetenekli = daha riskli” denklemini koruma katmanlariyla dengelemeye calisan bir surum. Bir muhendis olarak bu beni, ozellikle ajan ve bilgisayar-kullanimi (computer-use) senaryolarinda, modele verilen izin ve erisim kapsamini dar tutmaya yoneltir.
GPT-6.1 Astra neden yoktu?
Bir ayrinti kafa karistirabilir: Neden dogrudan GPT-6’dan GPT-6.2 Astra’ya gectik? Cunku OpenAI, GPT-6.1 Astra’yi guvenlik gerekceleriyle yaklasik iki ay once iptal etmisti. 6.2 nesli, o iptalden sonra gelen ilk Astra guncellemesi. Bu gecmis, OpenAI’nin frontier modellerde artik daha temkinli bir surum takvimi izledigini gosteriyor; ve sistem kartindaki detayli guvenlik degerlendirmeleri de bu temkinin bir parcasi.
Benim degerlendirmem: kime, ne zaman?
Modelleri kendi is yukumde henuz denemedim, ama duyuru ve bagimsiz raporlar isiginda su cercevede dusunuyorum. Gunluk otomasyon, rapor ozetleme, ic araclar ve cok adimli ajan akislari icin varsayilan tercih Sol olmali; fiyat/performans dengesi burada belirgin sekilde iyi. Hukuki metin analizi, finansal modelleme, karmasik kod tabanlari ve bilimsel is yukleri gibi hata maliyeti yuksek gorevlerde Astra‘yi devreye almak mantikli, ozellikle de %20’lik fiyat indirimiyle birlikte onceki nesle gore daha ulasilabilir hale geldigi icin.
Ne olursa olsun, bir modeli uretime tasimadan once kendi degerlendirme setinizle (eval) test etmeden karar vermeyin. Ureticinin benchmark’lari yon gosterir; sizin is yukunuzdeki gercek performansi degil. Erisim saglayip kendi testlerimi yaptigimda, somut gorev maliyetleri ve kod kalitesi uzerine ayri bir degerlendirme yazisi hazirlamayi planliyorum.
Bir yanıt yazın