GDPx: En İyi Yapay Zeka Modeli Bile Yalnızca %12 Aldı
GDPx: En İyi Yapay Zeka Modeli Bile Yalnızca %12 Aldı
Bugün masama oturup gündeme baktığımda günün en çok konuşulacak teknoloji gelişmesini seçmek zor olmadı. SemiAnalysis, 2 Kasım 2026’da GDPx adını verdiği yeni bir yapay zeka ölçüm testini yayınladı ve ortaya çıkan tek bir sayı, haftalardır süren “yapay zeka her işi devralıyor” tartışmasına soğuk su gibi düştü: test edilen en iyi model bile yalnızca %12 başarı aldı.
Bir sistem mühendisi olarak bu tür başlıkları önce şüpheyle karşılarım. O yüzden duyuruyu resmi kaynağından okudum, bağımsız birden fazla haberle çapraz kontrol ettim ve neyin gerçekten yeni, neyin pazarlama olduğunu ayıklamaya çalıştım. Sonuç gerçekten ilgi çekici; çünkü bu test, modelleri tam da benim ve çoğu mühendis arkadaşımın gerçekten umursadığı sahalarda sınıyor.
GDPx tam olarak ne ve neden önemli?
GDPx’i, çip analizleriyle tanınan araştırma firması SemiAnalysis (Max Kan, Andrew Megalaa ve Dylan Patel imzasıyla) hazırladı. Firmanın tanımıyla GDPx, “frontier zeka için en değerli alanları kapsayan” ve “genel ajan yeteneklerini ölçen dünyanın en iyi testi” olmayı hedefleyen bir benchmark.
Buradaki asıl mesele şu: Mevcut testlerin çoğu, modele tek seferlik soru sorup cevabı puanlıyor. GDPx ise modeli gerçek bir iş ortamına oturtuyor; saatlerce süren, araç kullanmayı, dosya açmayı, kod çalıştırmayı gerektiren ajan görevleri veriyor. SemiAnalysis açıkça OpenAI’ın geçen yıl çıkardığı GDPval testini yetersiz buluyor: GDPval’in görevleri etkileşimli değil, gerçekçi bir ortamı yok ve puanlaması gürültülü. GDPx tam da bu boşluğu kapatmak için kurulmuş.
Neden bu alanlar? Çünkü SemiAnalysis’in tezine göre “yapay zekanın ilk bir trilyon dolarlık geliri, frontier zekayı yüksek getiriyle kullanabilen sektörlerde yoğunlaşacak.” Yani soru artık “yapay zeka sınavı geçer mi” değil; “parayı gerçekten kazandıran, zor işleri yapabilir mi?”
Test masasında ne var? 11 yüksek değerli alan
GDPx, modelleri 11 farklı ve oldukça teknik alanda sınıyor. Listeye baktığımda bunun bir “genel kültür testi” olmadığı hemen belli oluyor; bunlar doğrudan mühendislik ve ağır bilgi işi sahaları:
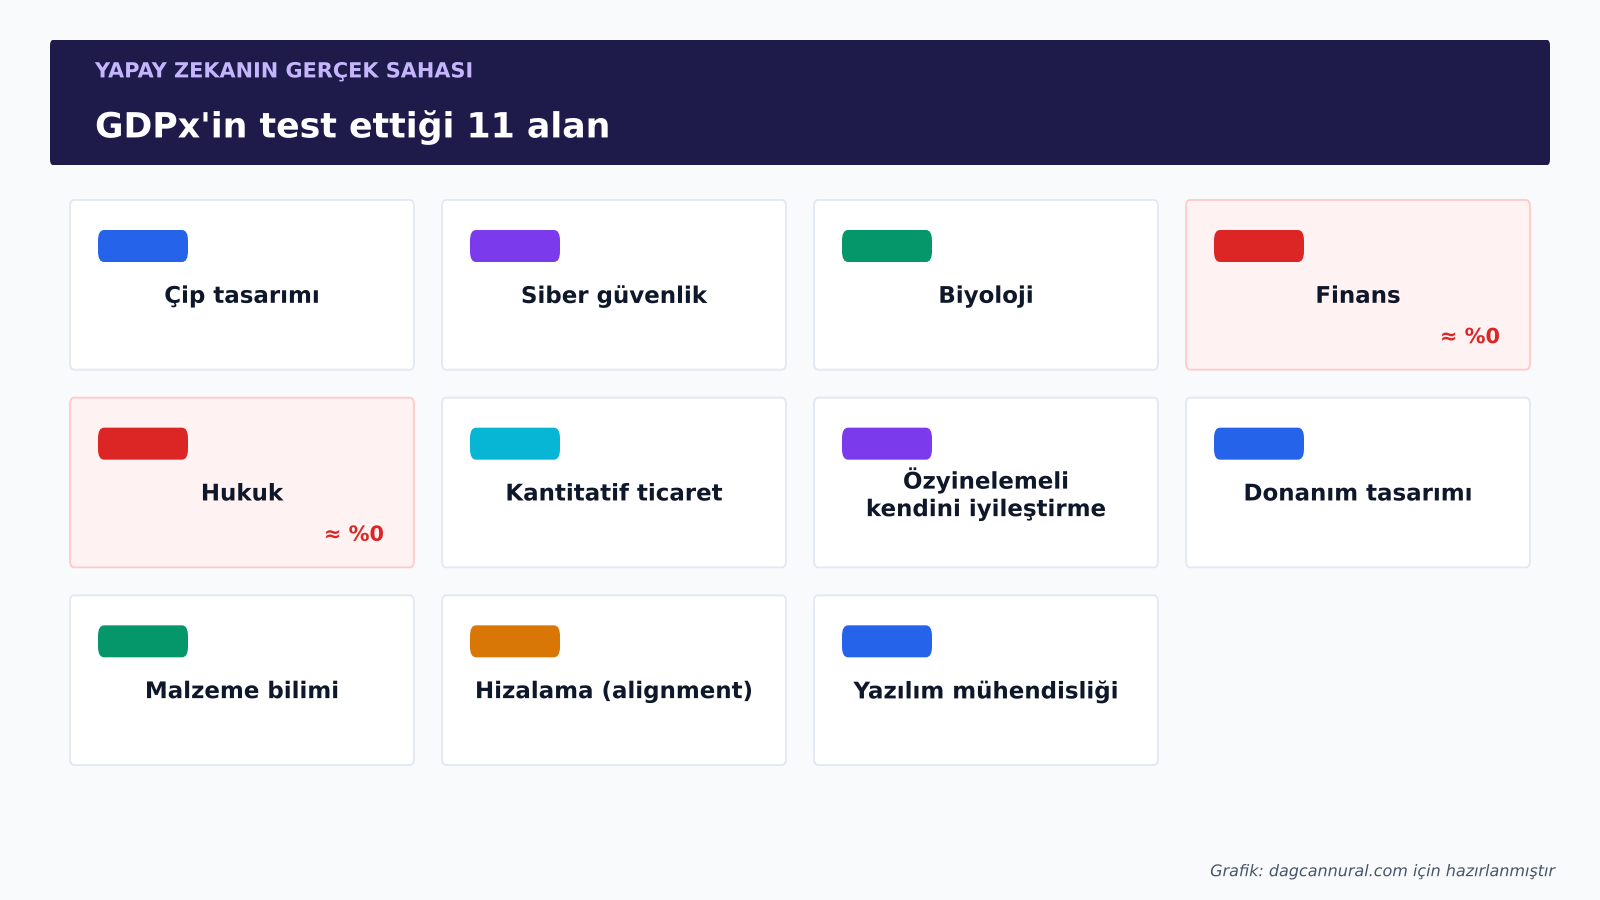
Çip tasarımından siber güvenliğe, biyolojiden kantitatif ticarete, hatta modelin “kendi kendini iyileştirmesi” (recursive self-improvement) ve yapay zeka hizalaması (alignment) gibi başlıklara kadar uzanan bir yelpaze var. Her alan, o işi gerçekten yapan uzman şirketler tarafından hazırlanmış. Toplam 14 veri ortağı var ve her alan puanlamada eşit ağırlık taşıyor; yani bir model yalnızca yazılımda iyi olduğu için zirveye çıkamıyor.
Sonuçlar: Zirvede Opus 5.5 var, ama tablo alçakgönüllü
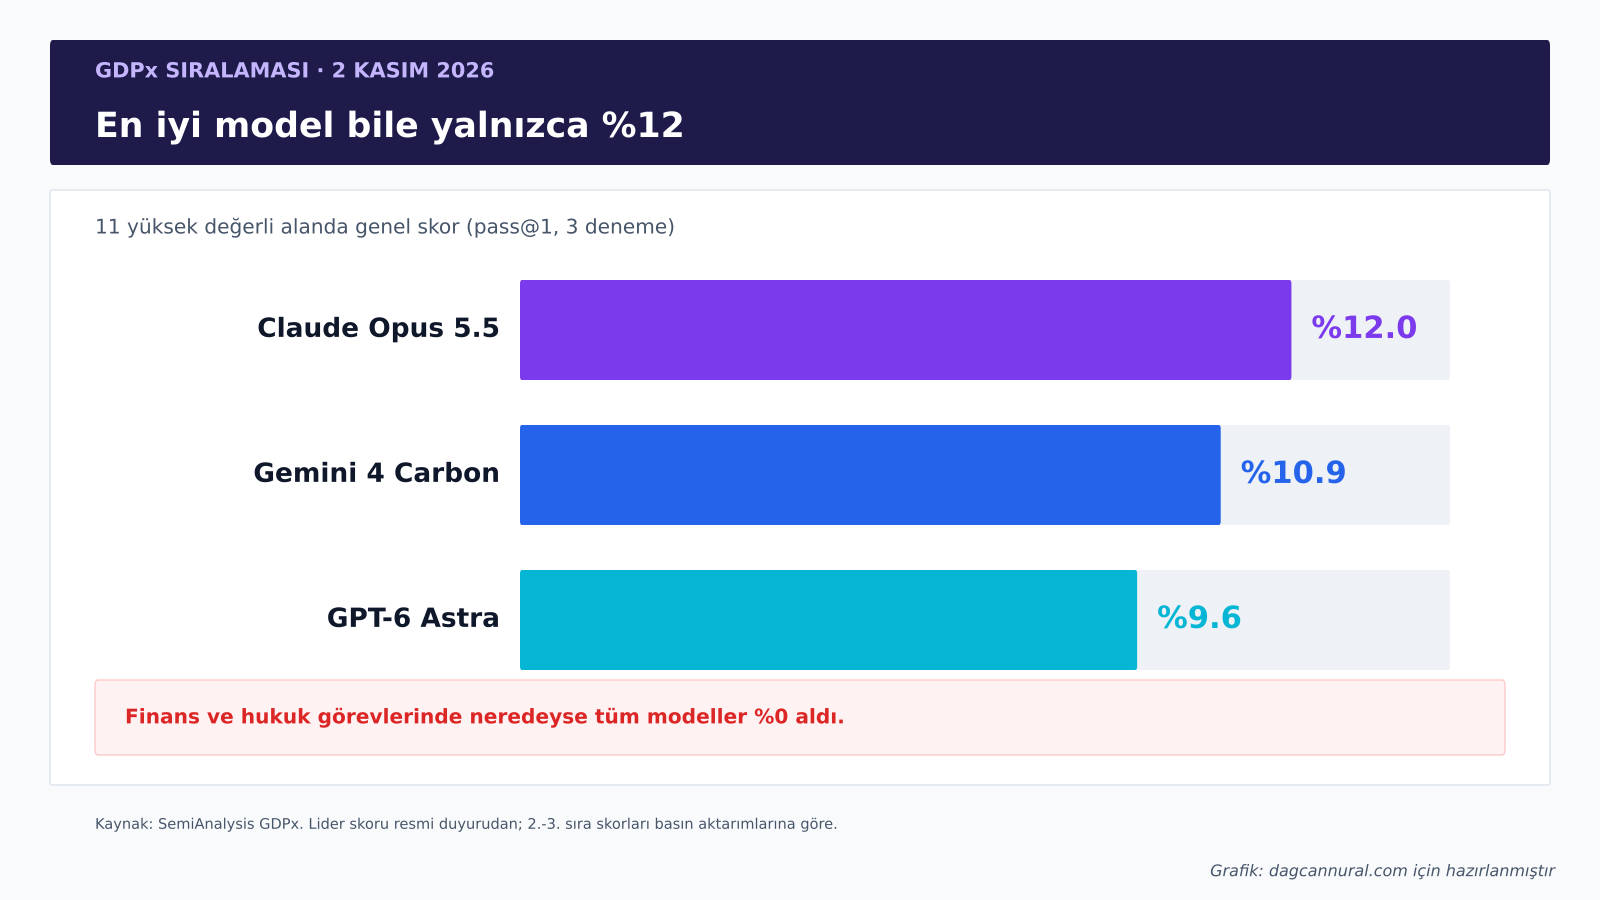
İşte günün manşeti burada. SemiAnalysis’in bildirdiği genel sıralamada Claude Opus 5.5 %12 ile lider. Basındaki aktarımlara göre onu %10,9 ile Gemini 4 Carbon ve %9,6 ile GPT-6 Astra izliyor.
Kafamı asıl kurcalayan rakam %12’nin kendisi. Sosyal medyada “yapay zeka artık her şeyi yapıyor” cümlesini her gün görüyoruz; ama sektörün en güçlü üç modeli, gerçek ve zor işlerde yüzde onlu bandı zar zor aşıyor. SemiAnalysis’in kendi ifadesiyle GDPx “gerçek bir frontier seviye test; en iyi model bile sadece %12 alıyor.” Bu, modellerin işe yaramadığı anlamına gelmiyor — tam tersine, zorlukta tavanı çok yükseğe koyan bir test olduğu anlamına geliyor.
Modellerin öne çıktığı alanlar da birbirinden farklı. SemiAnalysis’in değerlendirmesine göre tablo kabaca şöyle:
| Model | Genel skor | Öne çıktığı alanlar |
|---|---|---|
| Claude Opus 5.5 | %12,0 (lider) | Kantitatif ticaret, donanım tasarımı, çip tasarımı — “en dengeli model” |
| Gemini 4 Carbon | %10,9 | Biyoloji; yazılım mühendisliğinde başı çekiyor |
| GPT-6 Astra | %9,6 | Özyinelemeli kendini iyileştirme (RSI), malzeme bilimi |
| Muse Wonder Full | — | Bugün itibarıyla “açık ara en iyi siber güvenlik modeli” |
Maliyet/performans tarafında da ilginç bir denge var: SemiAnalysis’e göre düşük uçta Luna ve DeepSeek kapışıyor, yüksek uçta Opus kazanıyor, ortayı ise OpenAI tutuyor. Yani “en iyi model” sorusunun cevabı, bütçenize ve işinize göre değişiyor.
Finans ve hukukta tam sıfır — ve “sandbagging” meselesi
Beni mühendis olarak en çok düşündüren detay bu. SemiAnalysis açıkça şunu yazıyor: “Finans ve hukuk görevlerimiz o kadar zorlayıcı ki, temelde her model tam olarak sıfır alıyor.” Hukukta üretilen redline’ların hiçbiri kullanılabilir bulunmamış; bu da sonucu ikili puanlamada herkes için %0’a çevirmiş.
Bir diğer çarpıcı nokta güvenlik filtreleriyle ilgili. SemiAnalysis, Opus 5.5 ve GPT-6 Astra’nın bazı alanlarda “güvenlik sınıflandırıcıları yüzünden skorlarının baskılandığını” (sandbagging) söylüyor. Siber güvenlik, biyoloji ve hizalama alanları çıkarıldığında sıralama değişiyor. Yani modelin “yapamaması” ile “yapmaması/yapmasına izin verilmemesi” arasındaki fark, bu testte somut sayılara yansıyor. Üretim ortamında ajan kurarken bu ayrım hiç de akademik değil; doğrudan hangi işi hangi modele vereceğinizi belirliyor.
GDPx’i ciddiye almamın sebebi: metodoloji
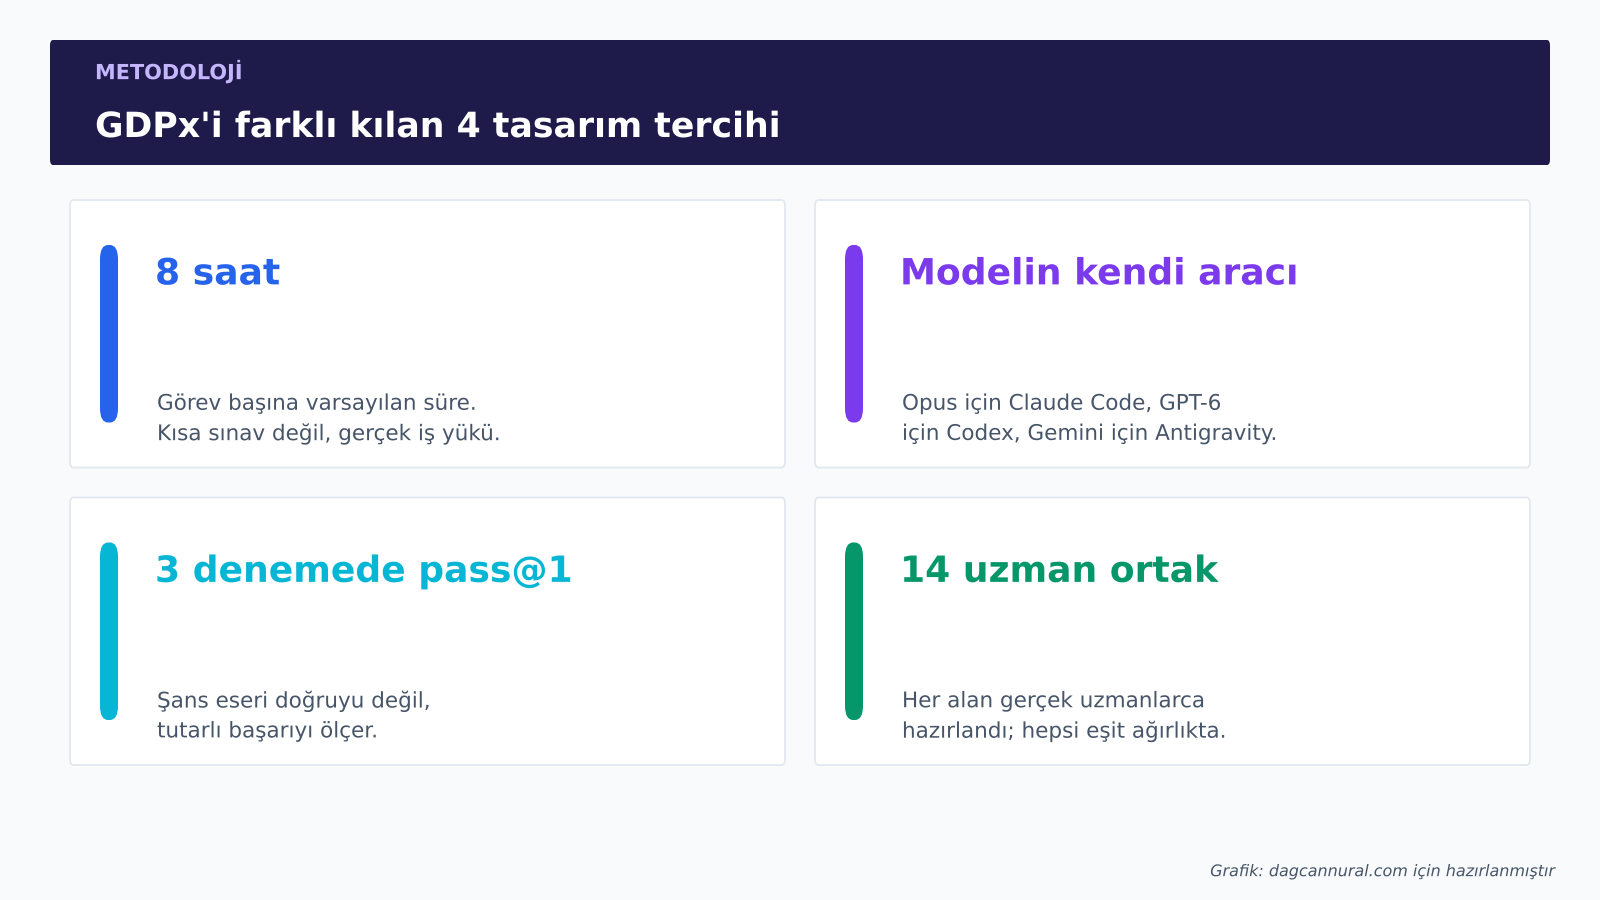
Bir testin sonucuna güvenip güvenmeyeceğime, sonuçtan önce nasıl ölçtüğüne bakarak karar veririm. GDPx’in dört tasarım tercihi, onu “parlak ama boş” benchmarklardan ayırıyor:
Birincisi, görev başına varsayılan süre 8 saat. Bu bir sınav değil, gerçek bir iş gününün simülasyonu. İkincisi, her model kendi doğal aracıyla çalışıyor: Opus için Claude Code, GPT-6 Astra için Codex, Gemini 4 Carbon için Antigravity; doğal aracı olmayan modeller için OpenCode kullanılıyor. Bu, “modeli kötü bir arayüzle test edip haksızlık etme” itirazını baştan kapatıyor.
Üçüncüsü, puan 3 denemede pass@1 olarak raporlanıyor; yani şans eseri bir kez tutturmak değil, tutarlı başarı ölçülüyor. Dördüncüsü ise kalite kontrolü: Görevler otomatik bir ajan QA sürecinden geçmek zorunda. SemiAnalysis’in çarpıcı bir notu var — aynı QA, popüler Terminal Bench 4.0 testine uygulandığında görevlerin neredeyse %50’sini “bozuk” olarak işaretliyor. Bu bile, piyasadaki birçok benchmark’ın ne kadar gevşek olduğunu gösteriyor.
Peki bu benim iş yüküme göre ne anlama geliyor?
Dürüst olayım: Ben bu modellerin hiçbirini GDPx’in test ortamında bizzat çalıştırmadım; bu testlere ve o özel harness’lara erişimim yok. O yüzden buradaki değerlendirmem kişisel bir deneyim değil, resmi duyuru ve bağımsız kaynaklar üzerinden bir mühendis okuması.
Yine de pratik çıkarımlar net. Birincisi, yapay zeka ajanlarını üretime alırken “model her şeyi halleder” varsayımından vazgeçmek gerekiyor; %12’lik bir tavan, insan denetiminin hâlâ zorunlu olduğunu söylüyor. İkincisi, alan seçimi kritik: Aynı model çip tasarımında parlarken finans ya da hukukta işe yaramayabiliyor. Türkiye’de bir ekip kurup bu araçları iş akışına koyacaksak, “hangi model” sorusundan önce “hangi iş” sorusunu sormamız lazım. Üçüncüsü, güvenlik filtrelerinin skorları baskılaması, kurumsal kullanımda modelin reddetme davranışlarını önceden test etmemiz gerektiğini hatırlatıyor.
Benim için GDPx’in asıl değeri sıralamanın kendisi değil; sektöre “abartıyı bırakın, gerçek işlerde neredesiniz” diye tuttuğu ayna. Ve o aynada şimdilik hepimiz, en güçlü modeller dahil, yolun başındayız.
GDPx nedir?
SemiAnalysis’in 2 Kasım 2026’da yayınladığı, yapay zeka modellerini çip tasarımı, siber güvenlik, biyoloji, finans, hukuk gibi 11 yüksek değerli alanda ajan görevleriyle sınayan bir benchmark’tır.
Hangi model birinci oldu?
Genel sıralamada Claude Opus 5.5 %12 ile lider oldu. Basın aktarımlarına göre Gemini 4 Carbon (%10,9) ikinci, GPT-6 Astra (%9,6) üçüncü sırada yer aldı.
En iyi model neden sadece %12 aldı?
Çünkü GDPx görevleri kasıtlı olarak çok zor; gerçek, saatler süren uzman işlerini simüle ediyor. SemiAnalysis’e göre finans ve hukuk görevlerinde neredeyse tüm modeller sıfır alıyor. Düşük skor modellerin başarısız olduğunu değil, testin tavanının çok yüksek olduğunu gösteriyor.
Bu test Türkiye’deki geliştiriciler için neden önemli?
Yapay zeka ajanlarını üretime alırken hangi modelin hangi işte güçlü olduğunu ve insan denetiminin hâlâ şart olduğunu somut verilerle gösteriyor. Model seçimi ve iş akışı tasarımı için gerçekçi bir referans sunuyor.
Değerlendirmem: GDPx, “yapay zeka her işi devraldı” anlatısına karşı bugün en somut cevabı verdi. En güçlü modeller bile gerçek, zor işlerde %12 bandında; finans ve hukukta ise sıfır. Bence asıl haber, bir modelin birinci olması değil; sektörün kendi performansını bu kadar dürüst ölçen bir teste ihtiyaç duymuş olması. Ajan çağına girerken en değerli pusula, abartı değil işte böyle sert ve şeffaf ölçümler.
Bir yanıt yazın