Microsoft 365 Çöküşü: Temmuz’daki Gizli Bug Patladı
Microsoft 365 Çöküşü: Temmuz’daki Gizli Bug Patladı
Geçen hafta pek çoğumuzun sabahı Outlook’a girememekle başladı. 12 Kasım’da
başlayan ve neredeyse bir güne yayılan Microsoft 365 kesintisi; Outlook,
Exchange Online, Teams, SharePoint ve Copilot’u aynı anda devre dışı bıraktı.
Ben de o gün birkaç saat boyunca e-posta akışının durduğunu, Teams
bildirimlerinin gecikmeli düştüğünü kendi ekibimde gözlemledim. O an “acaba
saldırı mı?” sorusu herkesin aklına geldi — ama değildi. Microsoft’un 15 Kasım’da
yayımladığı ön olay raporunu (preliminary post-incident report) ve EVP Charles
Lamanna’nın açıklamalarını kontrol ettiğimde, ortaya çıkan tablo bir sistem
mühendisi için saldırıdan çok daha öğretici: Temmuz’dan beri uykuda
bekleyen tek bir yazılım hatası, iki talihsiz koşulla birleşince küresel
bir çöküşe dönüştü.
Bu yazıda olayın zaman çizelgesini, kök nedenin tam anatomisini ve kendi iş
yüküme bakarak çıkardığım operasyon derslerini paylaşıyorum. Henüz Microsoft’un
20 Kasım’da gelmesi beklenen tam raporu yayımlanmadı; aşağıdaki değerlendirme
resmî ön rapor ve bağımsız teknoloji basınına (BleepingComputer, The Register,
Reuters) dayanıyor.
Kıvılcım: Temmuz’dan kalma “uyuyan” bir kusur
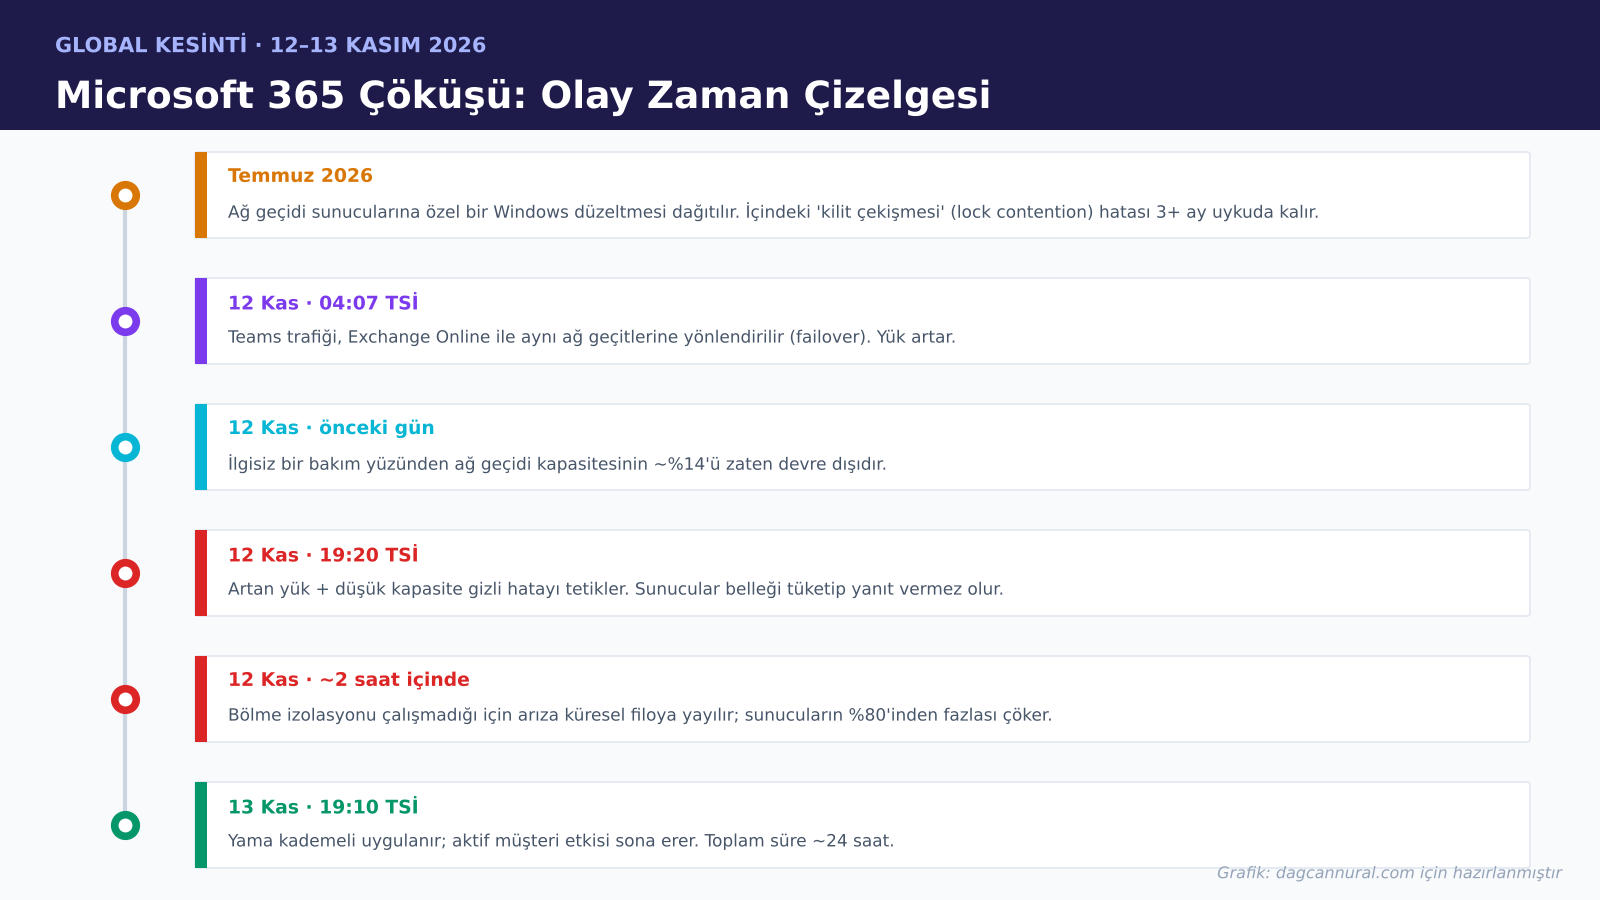
İşin kalbinde Microsoft’un “networking gateway” (ağ geçidi) adını verdiği ön
kapı sunucuları var. Exchange Online ve diğer pek çok M365 servisine gelen
bağlantılar bu sunuculardan geçiyor. Temmuz 2026’da Microsoft, yalnızca bu ağ
geçidi sunucularına özel bir Windows düzeltmesi dağıttı. Dikkat: bu düzeltme
sıradan Windows kurulumlarına değil, sadece bu gateway filosuna gidiyordu —
yani kendi sunucunuzda ya da PC’nizde yapacağınız hiçbir şey yoktu.
Bu düzeltmenin içinde bir kilit çekişmesi (lock contention)
kusuru vardı. Lamanna’nın ifadesiyle kusur üç aydan fazla dünya genelinde
sorunsuz çalıştı. Benim gözümde buradaki en sinsi nokta şu: bir değişikliğin
aylarca “temiz” görünmesi onu güvenli yapmıyor. Latent hatalar, ancak doğru
(ya da yanlış) yük profili geldiğinde tetikleniyor.
Fitili ateşleyen iki koşul
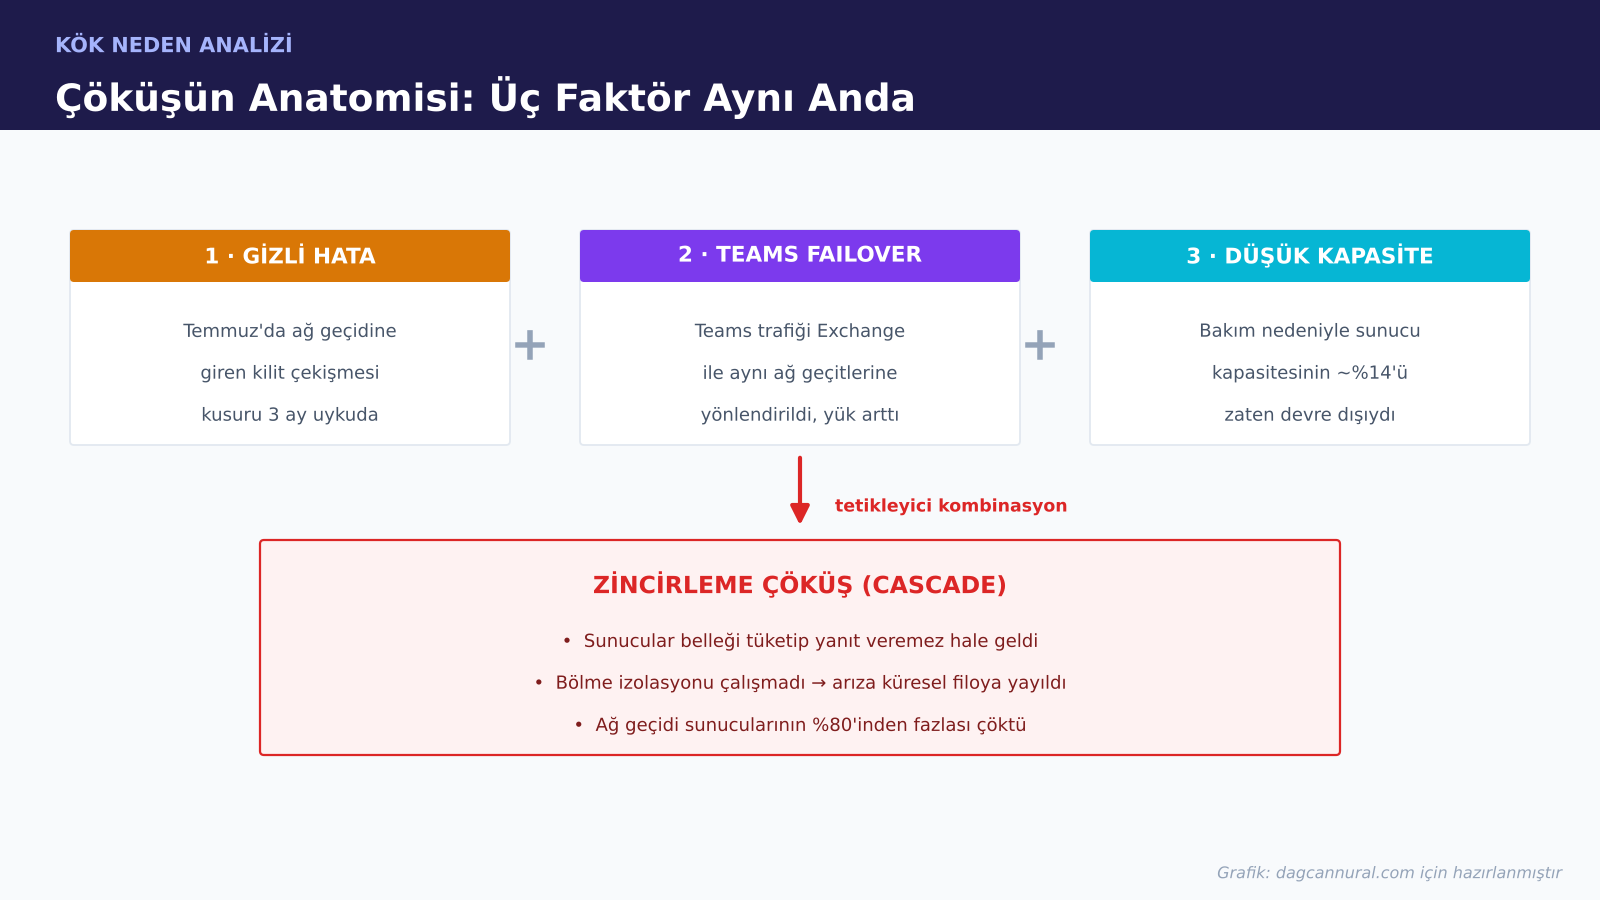
Hata tek başına uyumaya devam edebilirdi. Onu uyandıran iki şey aynı pencerede
üst üste bindi:
- Teams failover: Microsoft, Teams trafiğini Exchange
Online’a hizmet veren aynı ağ geçitlerine yönlendirdi (TSİ 04:07 civarı).
Bu, kritik gateway’ler üzerindeki yükü artırdı. - Düşük kapasite: Bir önceki gün, ilgisiz bir bakım
sorunu yüzünden ağ geçidi sunucu kapasitesinin yaklaşık %14’ü zaten devre
dışıydı. Microsoft, tek başına bunun sorun olmadığını, sistemin “yeterli
kapasite tamponuna” sahip olduğunu söylüyor.
Tek tek bakıldığında üçü de yönetilebilir görünüyor. Ama artan yük + azalan
kapasite + uyuyan hata aynı anda çakışınca, TSİ 19:20 civarında ağ geçidi
sunucuları belleklerini tüketip yanıt vermez hale geldi. Kilit çekişmesi tam da
bu noktada kritikleşiyor: yük düşükken birbirini bekleyen iş parçacıkları (thread)
sorun çıkarmaz; ama talep belirli bir eşiği aşınca bağlantı pazarlığı (connection
negotiation) kilitlenmeye başlıyor, bekleyen istekler birikiyor ve sunucu kendi
belleğinde boğuluyor. Microsoft’un raporunda da “rakip süreçlerin bağlantıların
işlenmesini engellediği” ifadesi tam olarak bunu anlatıyor.
Bu tablo bana klasik bir “gri arıza” (gray failure) desenini hatırlatıyor:
sistem tamamen ölmüyor, ama sağlıklı da değil — bir kısmı yanıt verirken bir
kısmı donuyor, ve bu belirsizlik teşhisi zorlaştırıyor. Üstelik kesinti, ABD’de
havayolu (United) kesintileri ve çeşitli servis arızalarıyla aynı haftaya denk
gelince kamuoyunda “her şey mi bozuldu?” algısı oluştu. Mühendislik tarafında ise
tablo net: tek bir kök neden, art arda gelen talihsizliklerle büyüdü.
Neden bu kadar hızlı yayıldı?
Beni en çok düşündüren kısım burası. Normalde modern bulut mimarilerinde
“bulkhead” (bölme) deseni vardır: bir bölgedeki arıza, gemi ambarındaki su
geçirmez bölmeler gibi diğerlerine sızmamalı. Bu olayda ayrı bir sorun, bölme
izolasyonunun devreye girmesini engelledi. Sonuç: kusur iki saatten kısa sürede
küresel filoya yayıldı ve en kötü anında sunucuların %80’inden
fazlası yanıt veremez hale geldi.
İşin bir başka ironik tarafı, Microsoft’un iki bağımsız gateway sistemi
işletmesi. Teams, sohbet ve toplantılar kesintinin büyük kısmında çalışmaya
devam etti çünkü alternatif ağ geçidine geçebildi. Exchange Online ise ölçek
gereği aynı geçişi yapamadı — e-postanın bu kadar uzun süre yerde kalmasının
sebebi de bu.
“Bu kusur, özellikle Microsoft 365 ağ geçidi sunucuları için hazırlanan bir
düzeltmenin sonucuydu; geniş Windows dağıtımlarını kapsamıyor.” — Charles
Lamanna, Microsoft EVP (Copilot, Agents and Platform)
Kurtarma neden 24 saat sürdü?
Bir kesintide asıl maliyet çoğu zaman “tespit + geri alma” süresidir. Burada
her iki aşama da uzadı. Microsoft’un anlatımına göre kök nedeni belirlemek
yaklaşık 15 saat, ardından düzeltmeyi kademeli dağıtmaya başlamak bir 15 saat
daha aldı. Kritik detay şu: hata üç aydır yerinde olduğu için feature
flag ve standart “flighting” (kademeli dağıtım) araçlarıyla hızlıca geri
alınamadı. Yani “son değişikliği geri al” refleksi burada işe yaramadı,
çünkü sorunlu kod artık “son değişiklik” değildi.
Microsoft, aktif müşteri etkisinin 13 Kasım TSİ 19:10 civarında sona erdiğini
doğruladı. Sonrasında kapasiteyi artırdığını, izlemeyi iyileştirdiğini ve trafik
yönlendirmesinin benzer bir zincirleme çöküşü tetiklemesini engelleyecek
koruyucular eklediğini açıkladı. Bu üç önlem — kapasite, gözlemlenebilirlik ve
yönlendirme koruması — aslında herhangi bir SRE ekibinin bir olay sonrası (post-mortem)
çıkaracağı standart aksiyon listesinin kurumsal ölçekteki hâli. Fark şu ki, bu
ölçekte “kademeli geri alma” bile saatler alabiliyor.
Benim iş yüküme göre: çıkarılacak dersler
Bu olayı kendi ortamımdaki e-posta ve kimlik bağımlılıklarına göre
değerlendirdiğimde, birkaç başlık öne çıkıyor. Hiçbiri “Microsoft’u bırakın”
değil; hepsi “tek noktaya olan bağımlılığı bilinçli yönetin” etrafında.
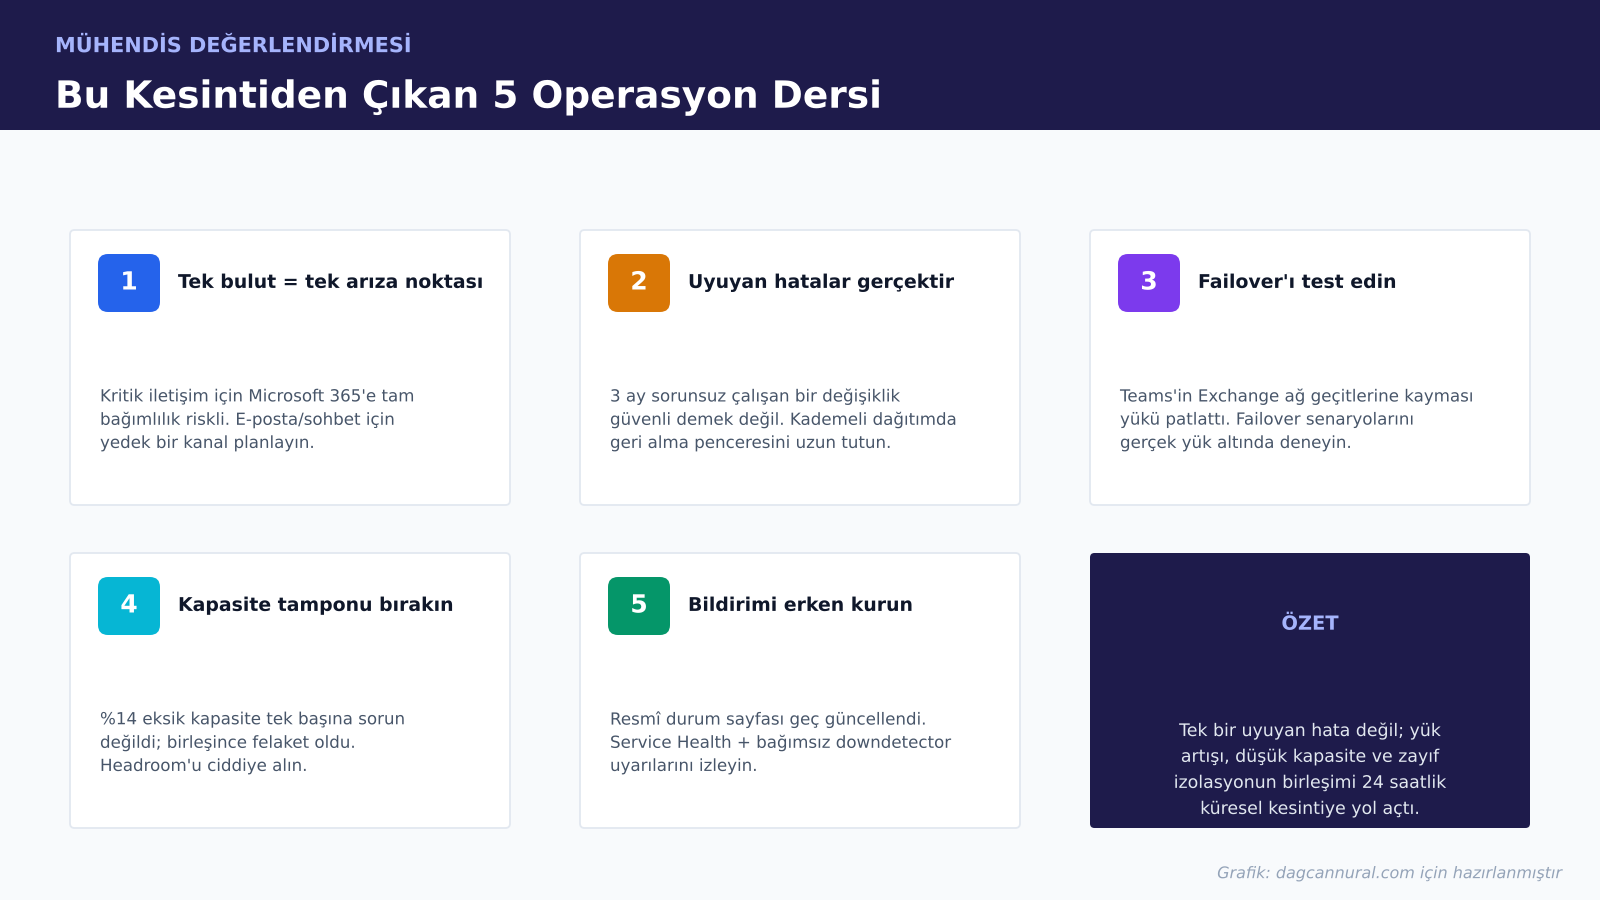
Pratikte ilk yapacağım şey, kritik bildirimlerin tek kanala (kurumsal
e-posta) bağlı kalmaması. İkincisi, tedarikçinizin kademeli dağıtım disiplinini
siz kontrol edemeseniz de, kendi değişiklik pencerelerinizde geri alma süresini
ölçmek. Üçüncüsü, Microsoft 365 Service Health panelini tek doğruluk kaynağı
saymamak; bağımsız bir downdetector sinyaliyle beslemek. Bu kesinti, “bulut =
her zaman çalışır” varsayımının değil, “bulut da bir başkasının bilgisayarıdır
ve o bilgisayar da çöker” gerçeğinin bir hatırlatıcısı oldu.
Microsoft 365 çöküşünün kök nedeni neydi?
Temmuz 2026’da ağ geçidi sunucularına özel bir Windows düzeltmesiyle giren bir
“kilit çekişmesi” (lock contention) hatası. Üç ay uykuda kaldı; Teams failover’ı
ve düşük kapasiteyle birleşince tetiklendi.
Kesinti ne kadar sürdü ve hangi servisleri etkiledi?
12 Kasım TSİ 19:20 civarında başladı, yaklaşık 24 saat sürdü. Outlook,
Exchange Online, Teams, SharePoint ve Copilot etkilendi. Aktif etki 13 Kasım
TSİ 19:10 civarında sona erdi.
Sorunu çözmek için benim bir şey yapmam gerekiyor mu?
Hayır. Hata yalnızca Microsoft’un gateway sunucularındaki bir düzeltmedeydi;
kullanıcı cihazlarında veya kurumsal istemcilerde yapılacak bir işlem yok.
Bu bir siber saldırı mıydı?
Hayır. Microsoft herhangi bir saldırı belirtisi olmadığını, nedenin dağıtılan
bir düzeltmedeki yazılım kusuru olduğunu belirtti.
Değerlendirmem
Bu, “kötü bir satır kod” hikâyesi değil; bir dayanıklılık (resilience)
hikâyesi. Tek bir latent hata, zayıf izolasyon ve ince kapasite tamponuyla
buluşunca 24 saatlik küresel bir kesintiye dönüşebiliyor. Microsoft’un tam olay
raporunu 20 Kasım’da yayımlaması bekleniyor; özellikle bölme izolasyonunun neden
devreye girmediğine dair detaylar, SRE tarafında hepimiz için değerli olacak.
O rapor çıktığında ayrıntılarıyla tekrar bakacağım.


Bir yanıt yazın